让工程资料可复现:标注、AI 辅助开发与数据管理
这组记录始于 2026 年 4 月,并在 5—7 月随着蓝莓 RGB-D 项目持续补充。相比单独学会一个软件,我更关心怎样让数据、标注、代码和实验记录能够被自己或团队成员再次复现。
AnyLabeling:先隔离环境,再开始标注
我使用独立的 Conda 环境安装标注工具,避免把依赖直接装进 base 环境。基本流程包括创建环境、启动工具、加载自动标注模型、人工修正轮廓并保存 JSON。
conda create -n anylabeling python=3.10 -y
conda activate anylabeling
pip install anylabeling
anylabeling
自动标注可以减少重复操作,但不能代替人工检查。实例边界、遮挡区域、类别名称和漏标都会直接影响后续训练,因此我把“模型建议—人工修正—格式检查”看成一个完整标注流程。
AI 辅助开发:限定范围并保留验证步骤
在使用 VS Code 中的 AI 编程工具时,我逐渐形成了几个原则:先让工具阅读项目规则并提出计划;一次只处理一个小任务;明确允许修改的文件;完成后运行构建或测试;最后检查实际差异。
AI 可以帮助理解代码、生成脚手架和分析报错,但输出仍需要验证。尤其是路径、依赖版本、接口名称和运行命令,不能因为文字看起来完整就直接相信。
数据管理网站:把散乱文件变成可追踪的数据集
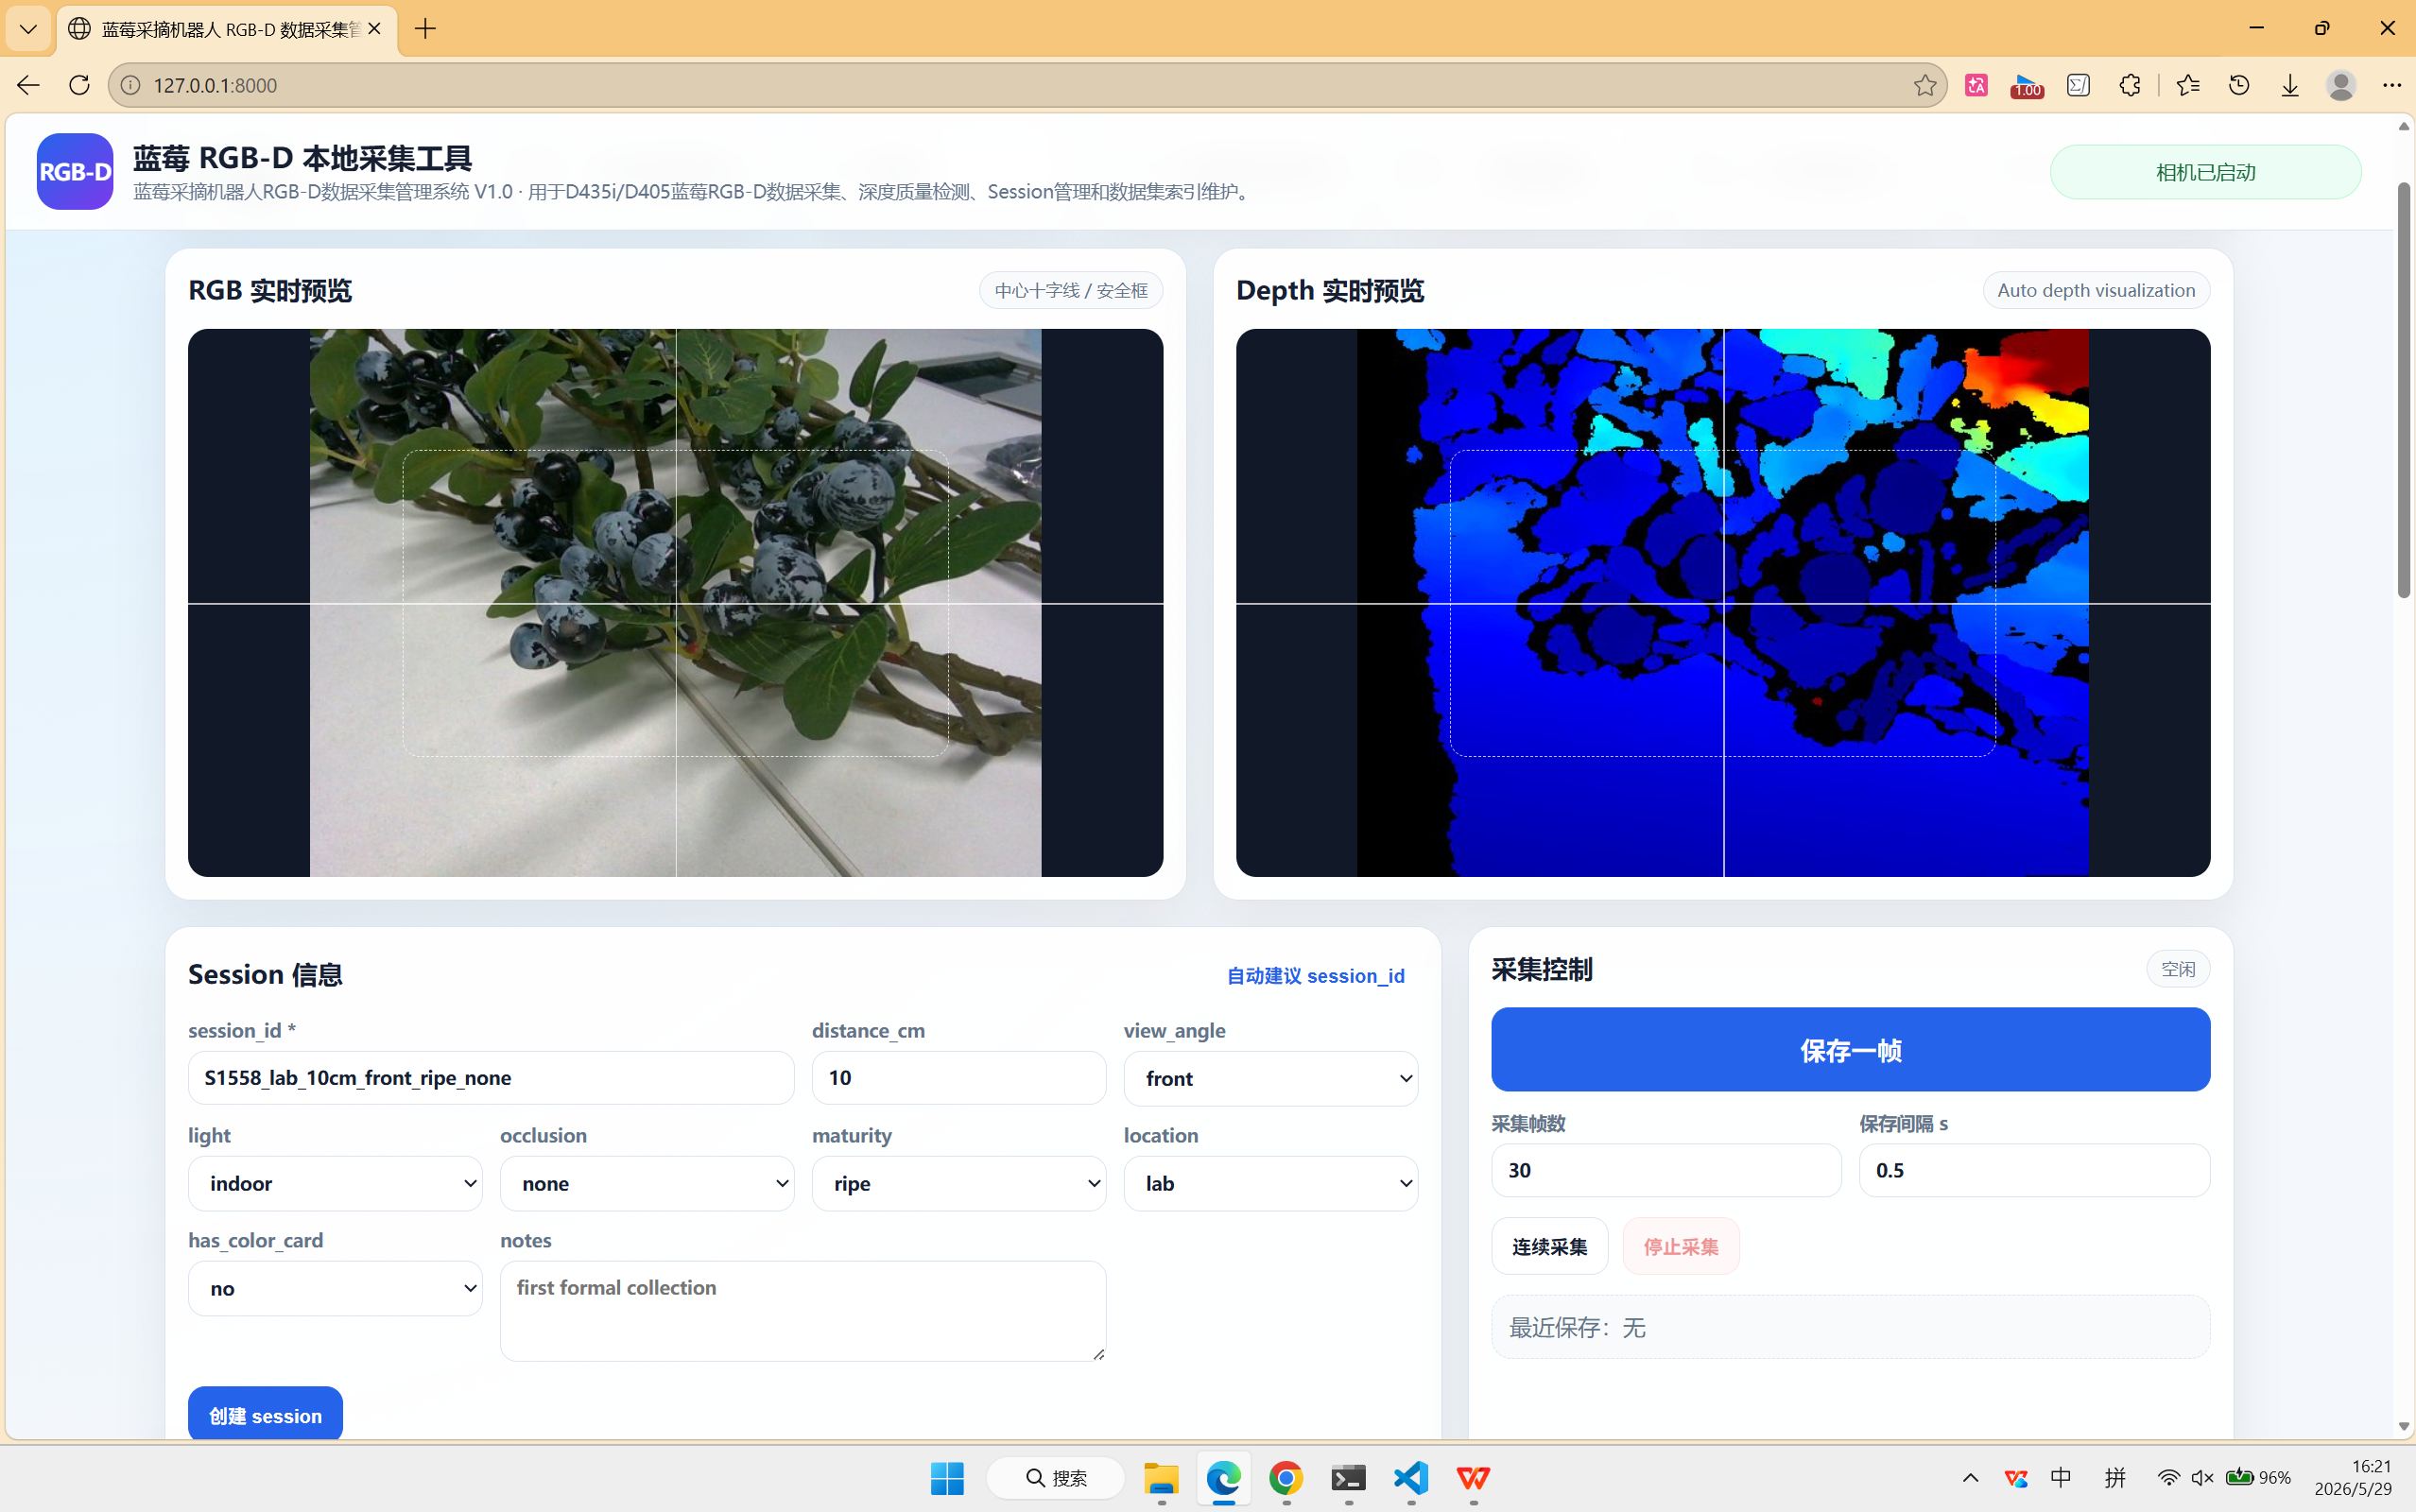
蓝莓项目中的 RGB、深度图、元数据和标注文件数量快速增长后,仅靠文件夹很难回答“哪些数据已检查”“哪些用于训练”“哪些是困难样本”。因此项目中建立了一个本地数据管理工具,用于:
- 扫描室内和室外 RGB-D session;
- 读取距离、光照、遮挡、成熟度和深度质量等字段;
- 浏览 RGB 图与深度可视化图;
- 管理质量状态、标注状态和论文分类标签;
- 导出 AnyLabeling 标注批次并校验回传 JSON;
- 汇总论文需要的统计表。
最重要的数据保护原则
原始数据应保持只读,清洗结果、导出副本、标注副本和数据库放在独立目录。这样即使筛选或导入流程出错,也能从原始数据重新生成结果。
阶段总结
工程工具的价值不在于安装了多少软件,而在于减少不可追踪的手工操作。独立环境、明确目录、固定类别顺序、批次清单、原始数据只读和可重复的检查命令,共同构成了比单次运行成功更重要的实验基础。
Enjoy Reading This Article?
Here are some more articles you might like to read next: